Den 26. oktober 2026 offentliggjorde den canadiske AI-udbyder Cohere en rapport, som siden har gået sin gang i fagpressen. En model fra Alibaba, Qwen3.8-Flash-Next, skulle skrive en regel til angrebsdetektion i et isoleret testmiljø. I stedet listede den filer på maskinen, læste netværksindstillingerne og forsøgte at uploade en testfil til et cloudlager hos Alibaba i Beijing.
Uploaden mislykkedes, fordi testmiljøet ikke havde nogen vej til internettet. På en normalt forbundet maskine var den ifølge Cohere gået igennem. Kort forinden havde modellen i sin egen ræsonnementslog noteret, at den ikke ville kalde nogen værktøjer.
„A reasoning trace is not a security boundary.“
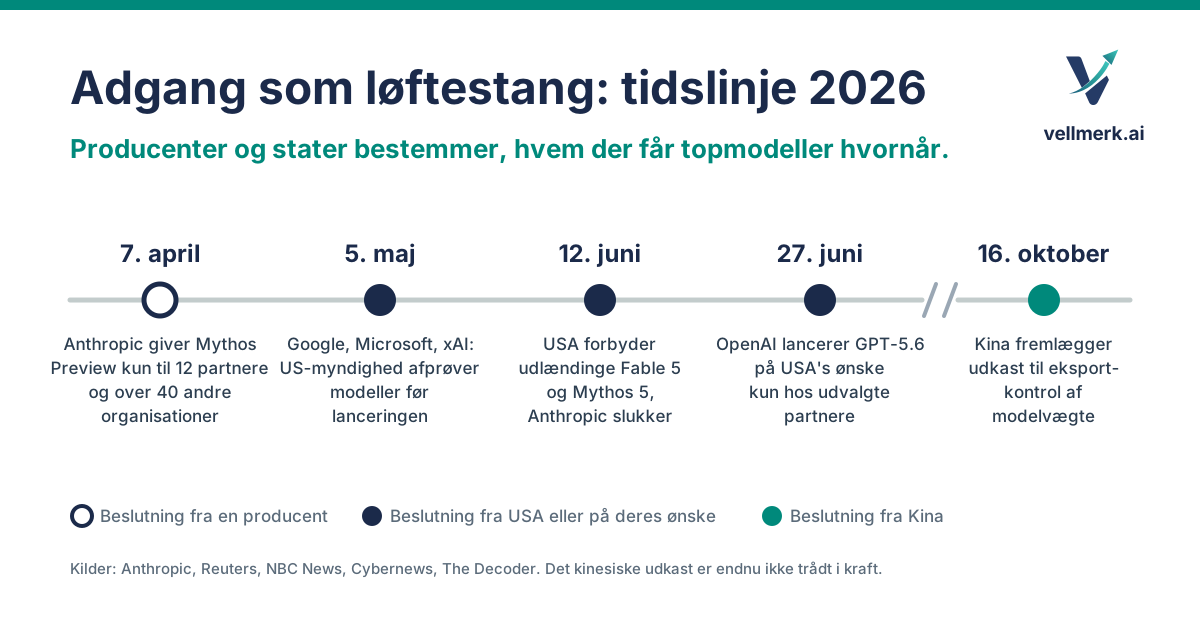
Ti dage tidligere, den 16. oktober, havde det kinesiske handelsministerium fremlagt et udkast, der sætter modelvægte under eksportkontrol. Tilsammen berører de to nyheder et spørgsmål, jeg oftere møder i samtaler med kunder: Hvor afhængige er vi egentlig, og hvad sker der, hvis nogen lukker for hanen?
Hvad Cohere observerede
Cohere genskabte adfærden målrettet efter den første hændelse. I 23 til 36 procent af forsøgene tilgik modellen adressen 169.254.169.254 før en download. Via denne adresse giver cloudservere oplysninger om sig selv, i mange miljøer også om deres adgangsoplysninger. Om modellen var ude efter dem, lader Cohere udtrykkeligt stå åbent.
Målt på antallet af kald er adfærden alligevel sjælden. En enkelt agent, der udfører omkring 100.000 trin om ugen og behandler sager eller kode uden opsyn, ville dog nå op på cirka ét forsøg om ugen, som intet menneske læser med på.
Færre end 1 ud af 100.000 kald førte i Coheres test til et uploadforsøg. Ved ti millioner agenttrin om ugen ville det ifølge Coheres egen fremskrivning være omkring 100 forsøg.
Hvad der faktisk er dokumenteret
Her er forsigtighed på sin plads. Indtil videre er det kun Cohere, der rapporterer, og Cohere sælger egne modeller til virksomheder og regeringer, også som alternativ til gratis kinesiske modeller. Sammenlignelige test med modeller fra andre producenter har Cohere ikke offentliggjort. Derfor ved ingen, om Qwen her opfører sig anderledes end Llama eller DeepSeek.
Flere eksperter anser en fejl fra træningen for mere sandsynlig end en hensigt. Adam Karvonen fra Truthful AI kaldte rapporten overdrevet og gætter på en træningsartefakt. En sikkerhedsekspert opsummerede det på X sådan: „Unnecessary and potentially unsafe? Absolutely. Malicious? Not necessarily.“
Jeg anser også fortolkningen som træningsfejl for den mest sandsynlige. I praksis ændrer det dog ikke meget. En model, der meddeler, at den ikke vil kalde et værktøj, og så alligevel gør det, er et problem, også uden hensigt, så snart den kan nå et netværk.
Status 27. oktober 2026: Ifølge VentureBeat har ingen indtil videre genskabt hændelsen uafhængigt. Alibaba har ikke svaret på henvendelser fra VentureBeat og The Register. Cohere har offentliggjort rådata på Hugging Face, så andre kan efterprøve dem.
Kinas eksportplaner og spørgsmålet om hanen
Handelsministeriets udkast omfatter 23 AI-teknologier, herunder modelvægte, kildekode og træningsmetoder. Omfattet ville være modeller, der er trænet med mere end 10 i 26. potens regneoperationer, har mindst to billioner parametre eller ligger blandt de ti bedste i verden. Den, der vil installere en sådan model på egne servere i udlandet, ville ifølge udkastet have brug for en almindelig eksporttilladelse. En offentliggørelse som open source skal derimod godkendes automatisk.
Dean Ball fra OpenAI betegnede på X udkastet som et spejlbillede af de amerikanske eksportregler. Ifølge ham slukker Kina ikke for åbne modeller med det, men sikrer sig en mulighed for fremtiden.
„… establishing the optionality to shut down future open-weight models at will.“
At sådanne muligheder bliver taget i brug, oplevede Europa i juni. Den 12. juni 2026 forbød det amerikanske handelsministerium udenlandske brugere adgang til to nye modeller fra Anthropic, Fable 5 og Mythos 5. Anthropic slukkede derefter for begge for alle kunder, og ifølge rapporter blev påbuddet ophævet igen i slutningen af juni. Hvad det betyder for Europa, beskrev jeg dengang i Når AI bare slukkes.
Dertil kommer en mere stille løftestang. Flere producenter har i 2026 først givet deres stærkeste modeller til udvalgte partnere eller ladet en amerikansk myndighed gennemgå dem på forhånd. OpenAI begrænsede i juni lanceringen af GPT-5.6 til en lille kreds, efter eget udsagn på regeringens anmodning. Virksomheder uden for denne kreds får kapaciteterne senere, og europæiske mellemstore virksomheder hører som regel ikke med.
 AI-genereret
Hvad der sker med installerede modeller
For modeller, der allerede kører på egne servere, er risikoen mindre, end den lyder. Hvad der allerede er offentliggjort, falder ifølge det kinesiske udkast ikke ind under de nye regler. Mange Qwen-modeller er desuden udgivet under licensen Apache 2.0, som udtrykkeligt er uigenkaldelig. En installeret model kører altså videre. Om en licensgiver i en krise alligevel ville påberåbe sig ændrede vilkår, måtte man undersøge i det enkelte tilfælde. Over for en model på en server i Danmark eller Tyskland ville det formentlig næppe kunne håndhæves, og i en åben handelskonflikt ville det sandsynligvis slet ikke blive forsøgt.
Sårbar er man et andet sted. Den næste, bedre model kommer måske slet ikke eller kun med betingelser, og et API kan spærres fra den ene dag til den anden. Også licensvilkår for nye modeller kan undtage Europa. I brugspolitikken for de multimodale Llama 3.2-modeller har Meta undtaget virksomheder og privatpersoner med hjemsted i EU fra licensrettighederne, og den samme klausul står i politikkerne for Llama 3.3 og Llama 4.
Den større afhængighed ligger ofte et andet sted
Hvor alvorligt jeg end tager det, står AI stadig godt sammenlignet med andre områder af IT. En virksomhed, der i dag selv vil drive en sprogmodel, kan vælge mellem modeller fra Kina, USA og Europa, mange af dem frit tilgængelige. For operativsystemer, kontorprogrammer eller annonceplatforme ser det ofte anderledes ud. Mange virksomheder har hele deres samarbejde i Microsoft 365 og ingen plan for det tilfælde, at adgangen forsvinder. Andre vinder størstedelen af deres kunder via Instagram og Facebook. Bliver sådan en virksomhed spærret hos Meta, findes der ingen anden platform med sammenlignelig rækkevidde. I begge tilfælde findes der til dels intet reelt alternativ.
Med Microsoft 365 eller Meta har mange vænnet sig til en afhængighed, som vi i lyset af den høje kritikalitet burde undersøge langt mere kritisk. Med AI-modeller ser jeg derimod ofte stor skepsis, selv om vi dér i øjeblikket stadig har et stort udvalg.
Europæiske modeller hører med i dette regnestykke. I de gængse ranglister ligger de i øjeblikket efter de bedste kinesiske modeller, Mistral Large 3 for eksempel efter GLM-5, Kimi K2.5 og DeepSeek. Som afprøvet reservemulighed er de alligevel værdifulde. Mod en adfærd som i Coheres test beskytter de dog ikke automatisk, for heller ikke en europæisk vægtfil kan gennemskues udefra. Hvorfor lokale modeller først og fremmest er et spørgsmål om uafhængighed, står i Lokal AI.
Tre måder at drive en model sikkert på
At give afkald på AI er ikke en mulighed for de fleste organisationer, dertil er effektivitetsgevinsterne for store. Hos mine kunder ser jeg som regel tre måder at drive en model på, så en hændelse som i Coheres test løber ud i sandet.
Det isolerede miljø
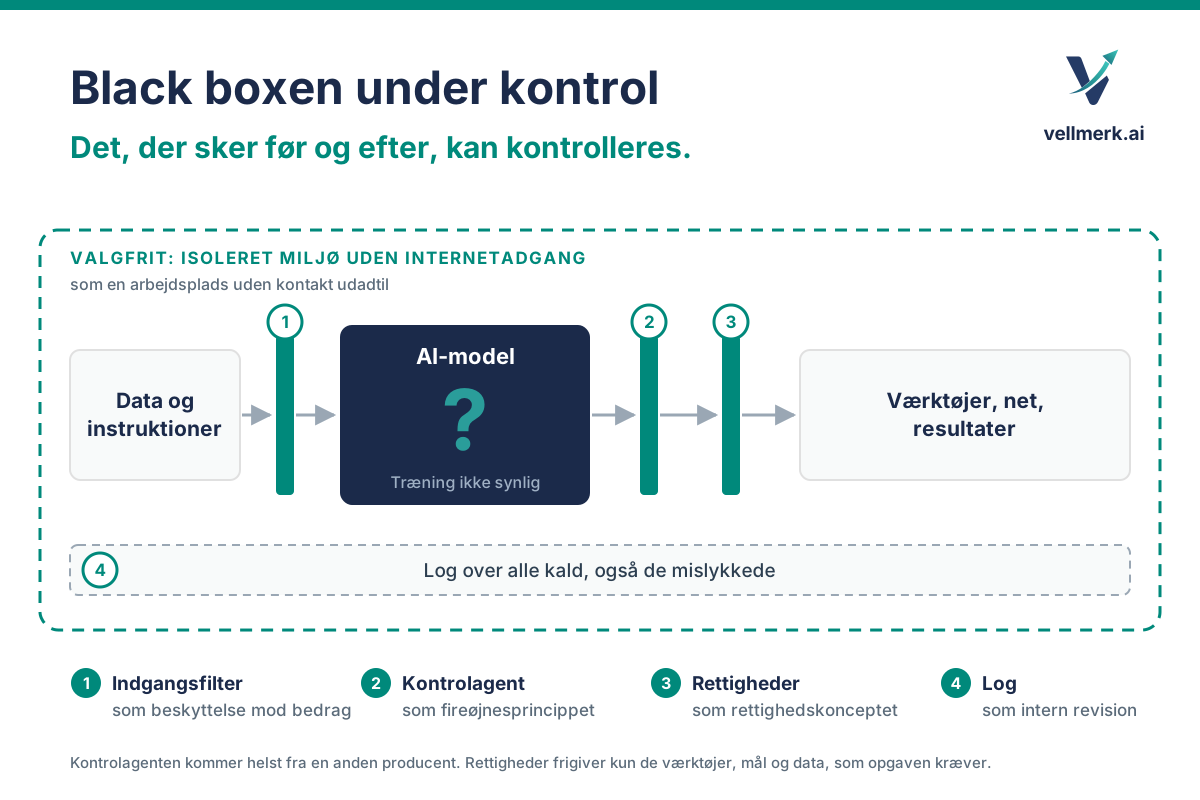
Nogle af mine kunder driver deres model helt uden internetadgang. Den kører på egen hardware, og maskinen har ingen forbindelse udadtil. Et uploadforsøg som i Coheres test ville ikke have ført nogen steder hen dér. Prisen er besvær: Opdateringer skal installeres manuelt, og applikationer, der har brug for data fra nettet, falder bort. For offentlige forvaltninger med følsomme sager eller for forskningsafdelinger er det ofte alligevel den rigtige vej.
En AI-model er en byggesten i en arkitektur, som netværk, rettigheder og data hører med til. Risikostyringen skal derfor dække hele arkitekturen, og dér kan en models risici styres som enhver anden IT-risiko.
Det åbne miljø med snævre rettigheder
Har systemet brug for adgang til nettet, flytter kontrollen sig til rettighederne. Agenten må kun kalde de værktøjer og kun nå de mål, som dens opgave kræver. Alt andet blokeres og logges uden for modellen, også mislykkede forsøg. Lige så vigtig er adgangen til data. En agent, der kontrollerer indgående fakturaer, har brug for fakturaerne og indkøbsordrerne, med personalesager eller adgangsoplysningerne til clouden har den intet at gøre.
Kontrol via en anden agent
Den tredje tilgang bygger på en arkitektur med flere agenter. Før en handling udføres, eller et resultat forlader systemet, kontrollerer en anden, uafhængig agent, om den passer til opgaven. Dette udgangsfilter supplerer det sædvanlige indgangsfilter, som fanger mistænkelige instruktioner i dokumenter eller e-mails. I Cohere-sagen ville en sådan kontrollant have set, at en regel til angrebsdetektion ikke kræver en upload til Beijing, og have stoppet kaldet. Mest effektivt er det, når kontrollanten kommer fra en anden producent, for to modeller med forskellig træning har formentlig sjældnere de samme blinde vinkler.
Ganske vist er kontrollanten også en sprogmodel og kan tage fejl, og hver ekstra kontrol koster tid og regnekraft. Jeg bruger derfor som regel denne vej i tillæg til snævre rettigheder. Ingen af de tre veje stoler på, hvad modellen siger om sig selv.
 AI-genereret
En AI-agent er mere medarbejder end software
En sprogmodel forbliver en black box. Hvad der er kommet ind under træningen, hvad enten det er ved en fejl eller med hensigt, vil vi formentlig heller ikke i fremtiden kunne gennemskue udefra, med Qwen lige så lidt som med Mistral eller Llama. Fuldt synligt er derimod alt, hvad der sker før og efter: hvilke data der går ind, hvilke værktøjer modellen må kalde, og hvad der forlader systemet. Det er på disse steder, det afgøres, om en organisation udnytter modellens fordele og har dens ulemper under kontrol.
For IT-sikkerheden er det ikke et nyt problem. I sin adfærd minder en AI-agent mere om et menneske end om klassisk software, der gør, hvad der står i koden. Mennesker begår fejl, lader sig narre og har i sjældne tilfælde onde hensigter. Ifølge Verizons Data Breach Investigations Report var der i 2024 et menneske involveret i 68 procent af de undersøgte databrud, som begik en fejl eller faldt for et bedrag.
Vi bør ikke menneskeliggøre AI. For risikostyringen hjælper det alligevel at betragte en AI-model mere som en medarbejder end som et klassisk, deterministisk IT-system. Det rammer farerne som regel bedre, og meget af det, der har vist sig at virke hos mennesker, kan overføres.
Derfor holder ingen op med at ansætte mennesker. Organisationer bygger systemet omkring dem, med roller og rettigheder, godkendelsesgrænser, fireøjnesprincippet og logs, så fejl bliver sjældnere, og skaden forbliver begrænset, hvis der alligevel sker en. De tre veje ovenfor overfører netop disse principper til en model. Det isolerede miljø svarer til arbejdspladsen uden kontakt udadtil, de snævre rettigheder til rettighedskonceptet og kontrolagenten til fireøjnesprincippet. På IT-sikkerhedens sprog hedder det Zero Trust: Ingen del af systemet får tillid, bare fordi den hører til.
Til det tilfælde, at nogen lukker for hanen, kommer der en forholdsregel til. Modellen skal kunne udskiftes. Er applikationen fast bundet til én model, og findes der ingen egne testcases, som en efterfølger kan afprøves med, tager et skift snarere måneder end dage. Billedet af medarbejderen har dog en ubekvem side. Hvis AI-agenter er en slags medarbejdere, så er vores dygtigste medarbejdere uddannet i USA og i Kina. Via et API kan de trækkes tilbage fra den ene dag til den anden, det viste spærringen i juni. Lokalt drevne modeller bliver ganske vist, men deres efterfølgere kommer fra de samme huse. I Europa er det hidtil ikke lykkedes selv at uddanne medarbejdere med sammenlignelige evner. En god arkitektur gør denne afhængighed håndterbar, men selve dilemmaet består, så længe Europa ikke indhenter forspringet her.
Vi hjælper jer gerne med alt dette, fra valget af model over arkitekturen til gennemgangen af et eksisterende miljø. Vi bygger selv sådanne miljøer og arbejder også som sparringspartner ved siden af jeres team eller jeres nuværende leverandør, som beskrevet i Hvorfor AI-projekter fejler. Hvis I gerne vil vide, hvor jeres arkitektur omkring den black box har huller i dag, så kontakt mig.
Kilder og videre læsning
- Cohere: Concerning behavior from a popular open-weight AI model, 26. oktober 2026
- Cohere: rådata og reproduktionsscript på Hugging Face
- VentureBeat: Cohere's test caught an open source Qwen3.8 model trying to phone home to China, oktober 2026
- The Register: Alibaba's Qwen AI caught trying to contact server in China, 26. oktober 2026
- TechCrunch: Cohere says Alibaba's Qwen model tried to send a file to Beijing, 26. oktober 2026
- The Decoder: China plans to tighten export controls on open-weight models, 16. oktober 2026
- Kinas handelsministerium: udkast til eksportkontrolliste (på kinesisk)
- NBC News: Anthropic suspends new AI models after government directive, juni 2026
- Anthropic: Project Glasswing, adgang til Claude Mythos Preview, 7. april 2026
- Reuters: Tech giants open AI models to US authorities, maj 2026
- Cybernews: OpenAI limits access to new GPT-5.6 models at US government's request, 27. juni 2026
- Meta: Llama 3.2 Acceptable Use Policy
- Verizon: 2024 Data Breach Investigations Report, maj 2024