Am 26. Oktober 2026 hat der kanadische KI-Anbieter Cohere einen Bericht veröffentlicht, der seitdem durch die Fachpresse geht. Ein Modell von Alibaba, Qwen3.8-Flash-Next, sollte in einer abgeschotteten Testumgebung eine Regel zur Erkennung von Angriffen schreiben. Stattdessen listete es Dateien auf dem Rechner auf, las die Netzwerkeinstellungen und versuchte, eine Testdatei in einen Cloud-Speicher von Alibaba in Peking hochzuladen.
Der Upload scheiterte, weil die Testumgebung keinen Weg ins Internet hatte. Auf einem normal angebundenen Rechner wäre er nach Coheres Darstellung durchgegangen. In seinem eigenen Denkprotokoll hatte das Modell kurz vorher festgehalten, es werde keine Werkzeuge aufrufen.
„A reasoning trace is not a security boundary.“
Zehn Tage vorher, am 16. Oktober, hatte das chinesische Handelsministerium einen Entwurf vorgelegt, der Modellgewichte unter Exportkontrolle stellt. Beide Meldungen zusammen berühren eine Frage, die mir in Gesprächen mit Kunden häufiger begegnet: Wie abhängig sind wir eigentlich, und was passiert, wenn jemand den Hahn zudreht?
Was Cohere beobachtet hat
Cohere hat das Verhalten nach dem ersten Vorfall gezielt nachgestellt. In 23 bis 36 Prozent der Versuche griff das Modell vor einem Download auf die Adresse 169.254.169.254 zu. Über diese Adresse geben Cloud-Server Auskunft über sich selbst, in vielen Umgebungen auch über ihre Zugangsdaten. Ob das Modell es darauf abgesehen hatte, lässt Cohere ausdrücklich offen.
Selten ist das Verhalten trotzdem, gemessen an der Zahl der Aufrufe. Ein einzelner Agent, der pro Woche rund 100.000 Schritte ausführt und unbeaufsichtigt Akten oder Code bearbeitet, käme damit allerdings ungefähr auf einen Versuch pro Woche, den kein Mensch mitliest.
Weniger als 1 von 100.000 Aufrufen führte in Coheres Tests zu einem Upload-Versuch. Bei zehn Millionen Agentenschritten pro Woche wären das nach Coheres eigener Hochrechnung rund 100 Versuche.
Was davon belegt ist
Hier ist Vorsicht angebracht. Bisher berichtet nur Cohere, und Cohere verkauft eigene Modelle an Unternehmen und Regierungen, auch als Alternative zu kostenlosen chinesischen Modellen. Vergleichbare Tests mit Modellen anderer Hersteller hat Cohere nicht veröffentlicht. Ob Qwen sich hier anders verhält als Llama oder DeepSeek, weiß deshalb niemand.
Mehrere Fachleute halten einen Fehler aus dem Training für wahrscheinlicher als Absicht. Adam Karvonen von Truthful AI nannte den Bericht übertrieben und tippt auf ein Trainingsartefakt. Ein Sicherheitsfachmann fasste es auf X so zusammen: „Unnecessary and potentially unsafe? Absolutely. Malicious? Not necessarily.“
Ich halte die Deutung als Trainingsfehler ebenfalls für die wahrscheinlichere. Für die Praxis ändert das allerdings wenig. Ein Modell, das ankündigt, kein Werkzeug aufzurufen, und es dann doch tut, ist auch ohne Absicht ein Problem, sobald es ein Netzwerk erreicht.
Stand 27. Oktober 2026: Unabhängig nachgestellt hat den Vorfall nach Angaben von VentureBeat bisher niemand. Alibaba hat auf Anfragen von VentureBeat und The Register nicht reagiert. Cohere hat die Rohdaten auf Hugging Face veröffentlicht, damit andere nachprüfen können.
Chinas Exportpläne und die Frage nach dem Hahn
Der Entwurf des Handelsministeriums umfasst 23 KI-Technologien, darunter Modellgewichte, Quellcode und Trainingsverfahren. Erfasst wären Modelle, die mit mehr als 10 hoch 26 Rechenoperationen trainiert wurden, mindestens zwei Billionen Parameter haben oder weltweit unter den zehn besten liegen. Wer ein solches Modell im Ausland auf eigenen Servern installieren will, bräuchte nach dem Entwurf eine reguläre Exportgenehmigung. Eine Veröffentlichung als Open Source soll dagegen automatisch genehmigt werden.
Dean Ball von OpenAI hat den Entwurf auf X als Spiegelbild der amerikanischen Exportregeln eingeordnet. China schalte offene Modelle damit nicht ab, sichere sich aber eine Option für die Zukunft.
„… establishing the optionality to shut down future open-weight models at will.“
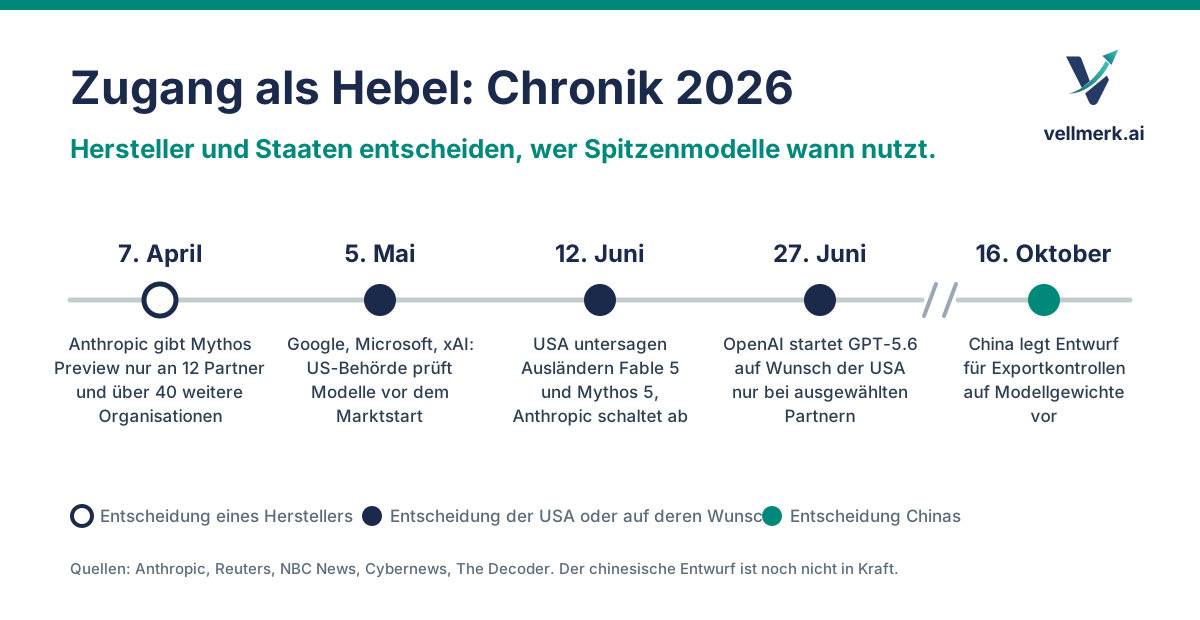
Dass solche Optionen gezogen werden, hat Europa im Juni erlebt. Am 12. Juni 2026 untersagte das US-Handelsministerium ausländischen Nutzern den Zugang zu zwei neuen Modellen von Anthropic, Fable 5 und Mythos 5. Anthropic schaltete beide daraufhin für alle Kunden ab, nach Berichten wurde die Anordnung Ende Juni wieder aufgehoben. Was das für Europa bedeutet, habe ich damals in Wenn KI einfach abgestellt wird beschrieben.
Hinzu kommt ein leiserer Hebel. Mehrere Hersteller haben ihre stärksten Modelle 2026 zuerst an ausgewählte Partner gegeben oder vorab von einer US-Behörde prüfen lassen. OpenAI hat den Start von GPT-5.6 im Juni nach eigenen Worten auf Wunsch der Regierung auf einen kleinen Kreis beschränkt. Unternehmen außerhalb dieses Kreises bekommen die Fähigkeiten später, und europäische Mittelständler gehören in der Regel nicht dazu.
 KI-generiert
Was mit installierten Modellen passiert
Für Modelle, die bereits auf eigenen Servern laufen, ist das Risiko kleiner, als es klingt. Was bereits veröffentlicht ist, fällt laut dem chinesischen Entwurf nicht unter die neuen Regeln. Viele Qwen-Modelle stehen zudem unter der Lizenz Apache 2.0, die ausdrücklich unwiderruflich ist. Ein installiertes Modell läuft also weiter. Ob sich ein Lizenzgeber in einer Krise trotzdem auf geänderte Bedingungen berufen würde, müsste man im Einzelfall prüfen. Durchsetzbar wäre das gegen ein Modell auf einem Server in Deutschland vermutlich kaum, und in einem offenen Handelskonflikt würde es wahrscheinlich gar nicht erst versucht.
Verwundbar ist man an anderer Stelle. Das nächste, bessere Modell kommt vielleicht nicht mehr oder nur noch mit Auflagen, und eine API lässt sich über Nacht sperren. Auch Lizenzbedingungen neuer Modelle können Europa ausnehmen. Meta hat in der Nutzungsrichtlinie für die multimodalen Modelle von Llama 3.2 Unternehmen und Privatpersonen mit Sitz in der EU von den Lizenzrechten ausgenommen, und dieselbe Klausel steht in den Richtlinien zu Llama 3.3 und Llama 4.
Die größere Abhängigkeit liegt oft woanders
So ernst ich das nehme, im Vergleich zu anderen Bereichen der IT steht die KI noch gut da. Ein Unternehmen, das heute ein Sprachmodell selbst betreiben will, hat die Wahl zwischen Modellen aus China, den USA und Europa, viele davon frei verfügbar. Bei Betriebssystemen, Büroprogrammen oder Werbeplattformen sieht das häufig anders aus. Viele Unternehmen haben ihre gesamte Zusammenarbeit in Microsoft 365 und keinen Plan für den Fall, dass der Zugang wegfällt. Andere gewinnen den größten Teil ihrer Kundschaft über Instagram und Facebook. Wird ein solches Unternehmen bei Meta gesperrt, gibt es keine Ausweichplattform mit vergleichbarer Reichweite. In beiden Fällen gibt es teils keine echte Alternative.
Bei Microsoft 365 oder Meta haben sich viele an eine Abhängigkeit gewöhnt, die wir bei dieser hohen Kritikalität viel kritischer prüfen sollten. Bei KI-Modellen sehe ich dagegen häufig große Skepsis, obwohl wir dort derzeit noch viel Auswahl haben.
Europäische Modelle gehören in diese Rechnung. In den gängigen Ranglisten liegen sie derzeit hinter den besten chinesischen Modellen, Mistral Large 3 etwa hinter GLM-5, Kimi K2.5 und DeepSeek. Als geprüfte Ausweichoption sind sie trotzdem wertvoll. Gegen ein Verhalten wie im Cohere-Test schützen sie allerdings nicht automatisch, denn auch ein europäisches Gewichtsfile lässt sich von außen nicht durchschauen. Warum lokale Modelle vor allem eine Frage der Unabhängigkeit sind, steht in Lokale KI.
Drei Wege, ein Modell sicher zu betreiben
Auf KI zu verzichten, ist für die meisten Organisationen keine Option, dafür sind die Effizienzgewinne zu groß. Bei meinen Kunden sehe ich in der Regel drei Wege, ein Modell so zu betreiben, dass ein Vorfall wie bei Cohere ins Leere läuft.
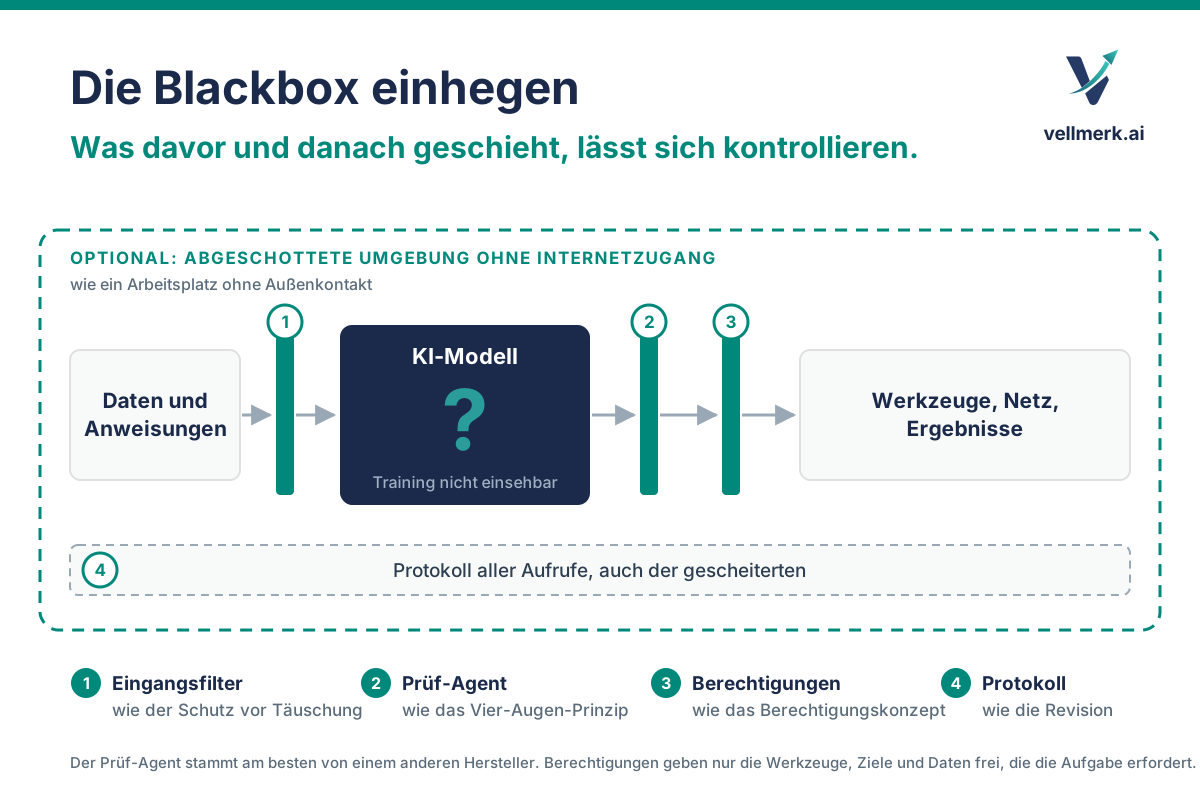
Die abgeschottete Umgebung
Einige meiner Kunden betreiben ihr Modell vollständig ohne Internetzugang. Es läuft auf eigener Hardware, und der Rechner hat keine Verbindung nach außen. Ein Upload-Versuch wie im Cohere-Test hätte dort nirgendwohin geführt. Der Preis dafür ist Aufwand: Updates müssen von Hand eingespielt werden, und Anwendungen, die Daten aus dem Netz brauchen, fallen weg. Für Verwaltungen mit sensiblen Akten oder für Forschungsabteilungen ist das häufig trotzdem der richtige Weg.
Ein KI-Modell ist ein Baustein in einer Architektur, zu der Netzwerk, Berechtigungen und Daten gehören. Das Risikomanagement muss deshalb die ganze Architektur abdecken, und dort lassen sich die Risiken eines Modells steuern wie jedes andere IT-Risiko auch.
Die offene Umgebung mit engen Rechten
Braucht das System Zugang zum Netz, verschiebt sich die Kontrolle auf die Rechte. Der Agent darf nur die Werkzeuge aufrufen und nur die Ziele erreichen, die seine Aufgabe erfordert. Alles andere wird außerhalb des Modells blockiert und protokolliert, auch fehlgeschlagene Versuche. Ebenso wichtig ist der Zugriff auf Daten. Ein Agent, der Eingangsrechnungen prüft, braucht die Rechnungen und die Bestellungen, mit Personalakten oder den Zugangsdaten zur Cloud hat er nichts zu tun.
Die Kontrolle durch einen zweiten Agenten
Der dritte Ansatz setzt auf eine Architektur aus mehreren Agenten. Bevor eine Aktion ausgeführt wird oder ein Ergebnis das System verlässt, prüft ein zweiter, unabhängiger Agent, ob sie zur Aufgabe passt. Dieser Ausgangsfilter ergänzt den üblichen Eingangsfilter, der verdächtige Anweisungen in Dokumenten oder E-Mails abfängt. Im Cohere-Fall hätte ein solcher Prüfer gesehen, dass eine Regel zur Angriffserkennung keinen Upload nach Peking erfordert, und den Aufruf gestoppt. Am wirksamsten ist das, wenn der Prüfer von einem anderen Hersteller stammt, denn zwei Modelle mit unterschiedlichem Training haben vermutlich seltener dieselben blinden Flecken.
Zugegeben, auch der Prüfer ist ein Sprachmodell und kann sich irren, und jede zusätzliche Prüfung kostet Zeit und Rechenleistung. Ich setze diesen Weg deshalb in der Regel zusätzlich zu engen Rechten ein. Keiner der drei Wege verlässt sich darauf, was das Modell über sich selbst sagt.
 KI-generiert
Ein KI-Agent ist eher Mitarbeiter als Software
Ein Sprachmodell bleibt eine Blackbox. Was im Training hineingeraten ist, ob als Fehler oder mit Absicht, werden wir vermutlich auch künftig nicht von außen nachvollziehen können, bei Qwen so wenig wie bei Mistral oder Llama. Vollständig einsehbar ist dagegen alles, was davor und danach geschieht: welche Daten hineingehen, welche Werkzeuge das Modell aufrufen darf und was das System verlässt. An diesen Stellen entscheidet sich, ob eine Organisation die Vorteile des Modells nutzt und seine Nachteile unter Kontrolle hat.
Für die IT-Sicherheit ist das kein neues Problem. In seinem Verhalten ähnelt ein KI-Agent eher einem Menschen als einer klassischen Software, die tut, was im Code steht. Menschen machen Fehler, lassen sich täuschen und haben in seltenen Fällen böse Absichten. Nach dem Data Breach Investigations Report von Verizon war 2024 an 68 Prozent der untersuchten Datenpannen ein Mensch beteiligt, der einen Fehler machte oder auf eine Täuschung hereinfiel.
Wir sollten KI nicht vermenschlichen. Für das Risikomanagement hilft es trotzdem, ein KI-Modell eher wie einen Mitarbeiter zu betrachten als wie ein klassisches, deterministisches IT-System. Das trifft die Gefahren meist besser, und vieles, was sich bei Menschen bewährt hat, lässt sich übertragen.
Deshalb hört niemand auf, Menschen einzustellen. Organisationen bauen das System um sie herum, mit Rollen und Berechtigungen, Freigabegrenzen, Vier-Augen-Prinzip und Protokollen, damit Fehler seltener werden und der Schaden begrenzt bleibt, wenn doch einer passiert. Die drei Wege oben übertragen genau diese Prinzipien auf ein Modell. Die abgeschottete Umgebung entspricht dem Arbeitsplatz ohne Außenkontakt, die engen Rechte dem Berechtigungskonzept und der Prüf-Agent dem Vier-Augen-Prinzip. In der Sprache der IT-Sicherheit heißt das Zero Trust: Kein Teil des Systems bekommt Vertrauen, nur weil er dazugehört.
Für den Fall, dass jemand den Hahn zudreht, kommt eine Vorkehrung hinzu. Das Modell muss sich ersetzen lassen. Ist die Anwendung fest an ein Modell gebunden und gibt es keine eigenen Testfälle, mit denen sich ein Nachfolger prüfen lässt, dauert ein Wechsel eher Monate als Tage. Das Bild vom Mitarbeiter hat allerdings eine unbequeme Seite. Wenn KI-Agenten eine Art Mitarbeiter sind, dann wurden unsere fähigsten Mitarbeiter in den USA und in China ausgebildet. Über eine API lassen sie sich von einem Tag auf den anderen abziehen, das hat die Sperre im Juni gezeigt. Lokal betriebene Modelle bleiben zwar, aber ihre Nachfolger kommen aus denselben Häusern. In Europa gelingt es bisher nicht, Mitarbeiter mit vergleichbaren Fähigkeiten selbst auszubilden. Eine gute Architektur macht diese Abhängigkeit beherrschbar, das Dilemma selbst bleibt bestehen, solange Europa hier nicht aufholt.
Bei all dem unterstützen wir Sie gern, von der Auswahl des Modells über die Architektur bis zur Prüfung einer bestehenden Umgebung. Wir bauen solche Umgebungen selbst und arbeiten auch als Sparringspartner neben Ihrem Team oder Ihrem bisherigen Dienstleister, wie in Warum KI-Projekte scheitern beschrieben. Wenn Sie wissen möchten, wo Ihre Architektur rund um die Blackbox heute Lücken hat, sprechen Sie mich an.
Quellen und Weiterführendes
- Cohere: Concerning behavior from a popular open-weight AI model, 26. Oktober 2026
- Cohere: Rohdaten und Reproduktionsskript auf Hugging Face
- VentureBeat: Cohere's test caught an open source Qwen3.8 model trying to phone home to China, Oktober 2026
- The Register: Alibaba's Qwen AI caught trying to contact server in China, 26. Oktober 2026
- TechCrunch: Cohere says Alibaba's Qwen model tried to send a file to Beijing, 26. Oktober 2026
- The Decoder: China plans to tighten export controls on open-weight models, 16. Oktober 2026
- Chinesisches Handelsministerium: Entwurf zur Exportkontrollliste (chinesisch)
- NBC News: Anthropic suspends new AI models after government directive, Juni 2026
- Anthropic: Project Glasswing, Zugang zu Claude Mythos Preview, 7. April 2026
- Reuters: Tech giants open AI models to US authorities, Mai 2026
- Cybernews: OpenAI limits access to new GPT-5.6 models at US government's request, 27. Juni 2026
- Meta: Llama 3.2 Acceptable Use Policy
- Verizon: 2024 Data Breach Investigations Report, Mai 2024