Seit 2022 berate ich zu Künstlicher Intelligenz, inzwischen also gut vier Jahre. Aus dieser Zeit sind mir zwei Gespräche besonders im Gedächtnis geblieben, und ich erzähle sie stellvertretend. Beide kommen aus der öffentlichen Verwaltung.
Im ersten lautete der Auftrag sinngemäß, man brauche jetzt auch etwas mit KI. Die Nachbarkommune habe so einen Chatbot auf der Homepage, den hätte man gern auch. Ein Problem, das gelöst werden sollte, kam in dem Gespräch gar nicht vor.
Ich habe noch kein Unternehmen gesehen, das durch einen Chatbot auf der Startseite besser geworden ist. Aber ich habe mehrere Organisationen erlebt, die danach glaubten, das Thema KI sei damit erledigt.
Im zweiten hatten wir über Modelle, Architekturen und automatisierte Abläufe gesprochen, mit und ohne KI. Dann kam der Einwand, man wisse doch noch gar nicht, welches Modell sich am Ende durchsetze. Besser warte man ab, bis das in etwa drei Jahren geklärt sei.
Das dritte Muster sehe ich seltener in Verwaltungen und häufiger in Unternehmen. Dort fließen erhebliche Mittel in einen Anwendungsfall, bei dem sich schon zu Beginn hätte überschlagen lassen, dass er sich nicht rechnet. Auch dann nicht, wenn alles genau so funktioniert, wie es geplant war.
Die drei Fälle haben auf den ersten Blick wenig miteinander zu tun. In keinem davon war die Technik das Problem.
Gefehlt hat jedes Mal die Arbeit davor. Es gab keinen sauber definierten Business Case, und es gab keine Reihenfolge, die sich danach richtete, welche Anwendung den größten Nutzen bringt. Für genau diese Reihenfolge nutze ich eine einfache Landkarte, die Vellmerk-Matrix, die Vorhaben nach Wirkung und Aufwand sortiert.
Damit stehe ich nicht allein. Es deckt sich mit dem, was ich im Austausch mit anderen Beratern höre und von Kunden, die vorher mit jemand anderem gearbeitet haben. Auch dort kommen Geschichten dazu, die in dieselbe Richtung gehen. Ein Pilot, der nie in Betrieb ging. Ein Modell, das auf Daten trainiert wurde, die niemand gepflegt hat. Eine Lösung, die technisch funktionierte und an der Stelle im Prozess saß, an der sie niemandem half.
Das ist anekdotisch, und ich will es nicht als mehr ausgeben. Was die Studienlage dazu sagt, hat mich beim Nachlesen in zwei Punkten überrascht, und in beiden Fällen nicht in die Richtung, die ich erwartet hatte.
Die meistzitierte Zahl der Branche hält nicht
Seit Sommer 2025 geistert eine Zahl durch jede Präsentation: 95 Prozent aller GenAI-Piloten brächten keinen Ertrag. Sie stammt aus einem Papier des MIT-Projekts NANDA vom Juli 2025, 26 Seiten, Untertitel „Preliminary Findings“. Dahinter stehen 153 ausgefüllte Fragebögen, 52 Interviews und eine Durchsicht öffentlich dokumentierter Initiativen, erhoben auf vier Branchenkonferenzen in einem Zeitfenster von sechs Monaten.
Kevin Werbach von der Wharton School hat öffentlich eingeräumt, dass er die Zahl im Dokument nicht findet: „I've read through the document multiple times, and I still can't understand where it comes from.“ Der Report ist nicht begutachtet, und er zählt jeden Piloten als Fehlschlag, der innerhalb von sechs Monaten nicht in den Vollbetrieb geht. Ein Teil davon sollte nie in Produktion, es waren Lernübungen und Anbietervergleiche.
Ich sage das nicht, um die Branche schönzureden. Ich sage es, weil ein Artikel über Fehler bei der KI-Einführung schlecht damit anfangen kann, selbst eine ungeprüfte Zahl weiterzureichen.
Die Zahl, die stattdessen zählt
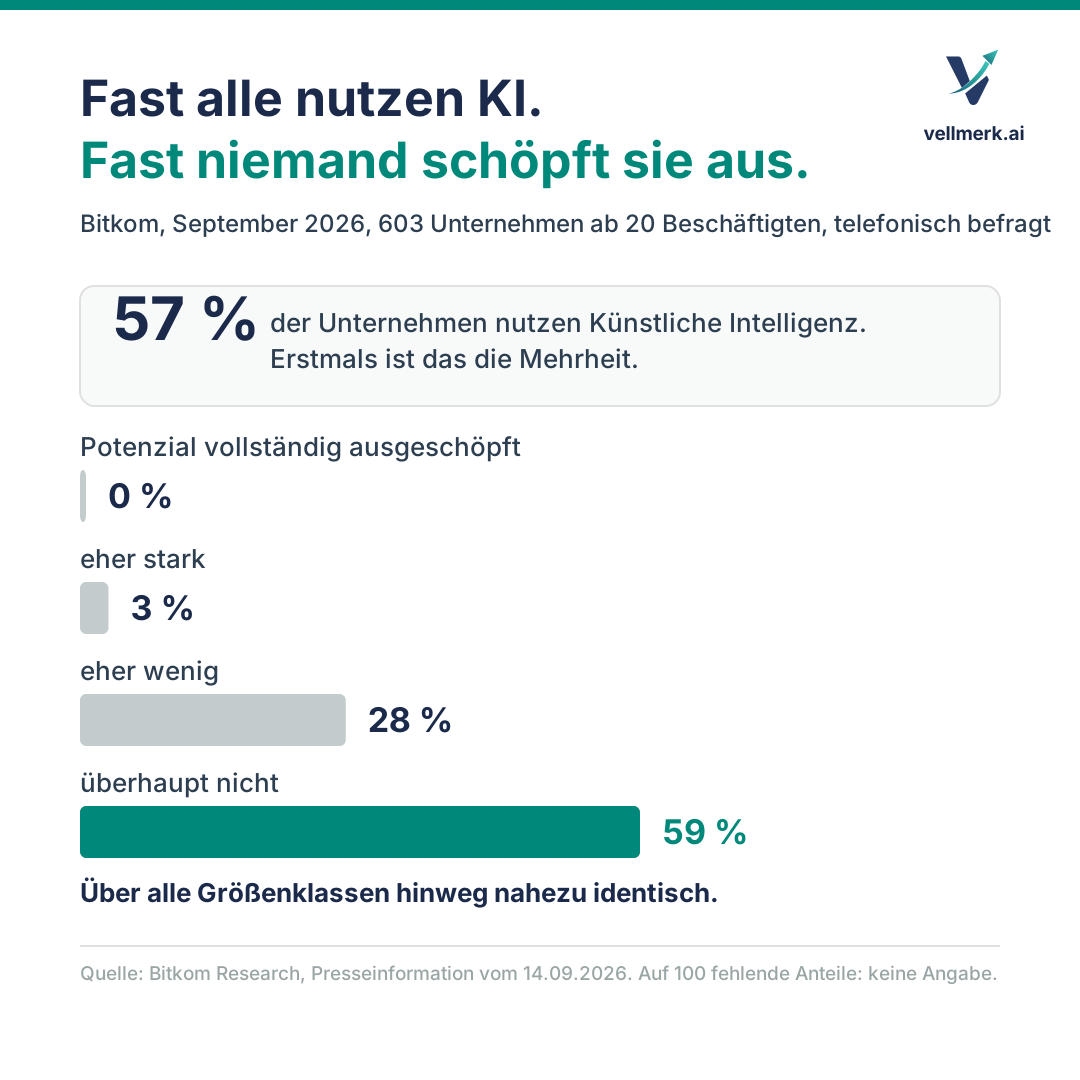
Der Bitkom hat im September 2026 603 Unternehmen ab 20 Beschäftigten telefonisch befragt. 57 Prozent nutzen KI, erstmals also die Mehrheit. 45 Prozent der Nutzer melden einen messbaren Beitrag zum Unternehmenserfolg. Die Behauptung, KI scheitere auf ganzer Linie, läuft den Daten hinterher.
Interessant wird es zwei Fragen später in derselben Erhebung. Gefragt, wie weit sie das Potenzial von KI im eigenen Haus ausschöpfen, antwortet kein einziges Unternehmen mit vollständig. 59 Prozent antworten mit überhaupt nicht, und zwischen den Größenklassen gibt es dabei kaum einen Unterschied.
Die Werkzeuge sind also da, und trotzdem bewegen sie fast nichts. Vielleicht, weil es die falschen sind, vielleicht, weil sie falsch eingesetzt werden.
 KI-generiert
Der Einzelne wird schneller, die Organisation steht
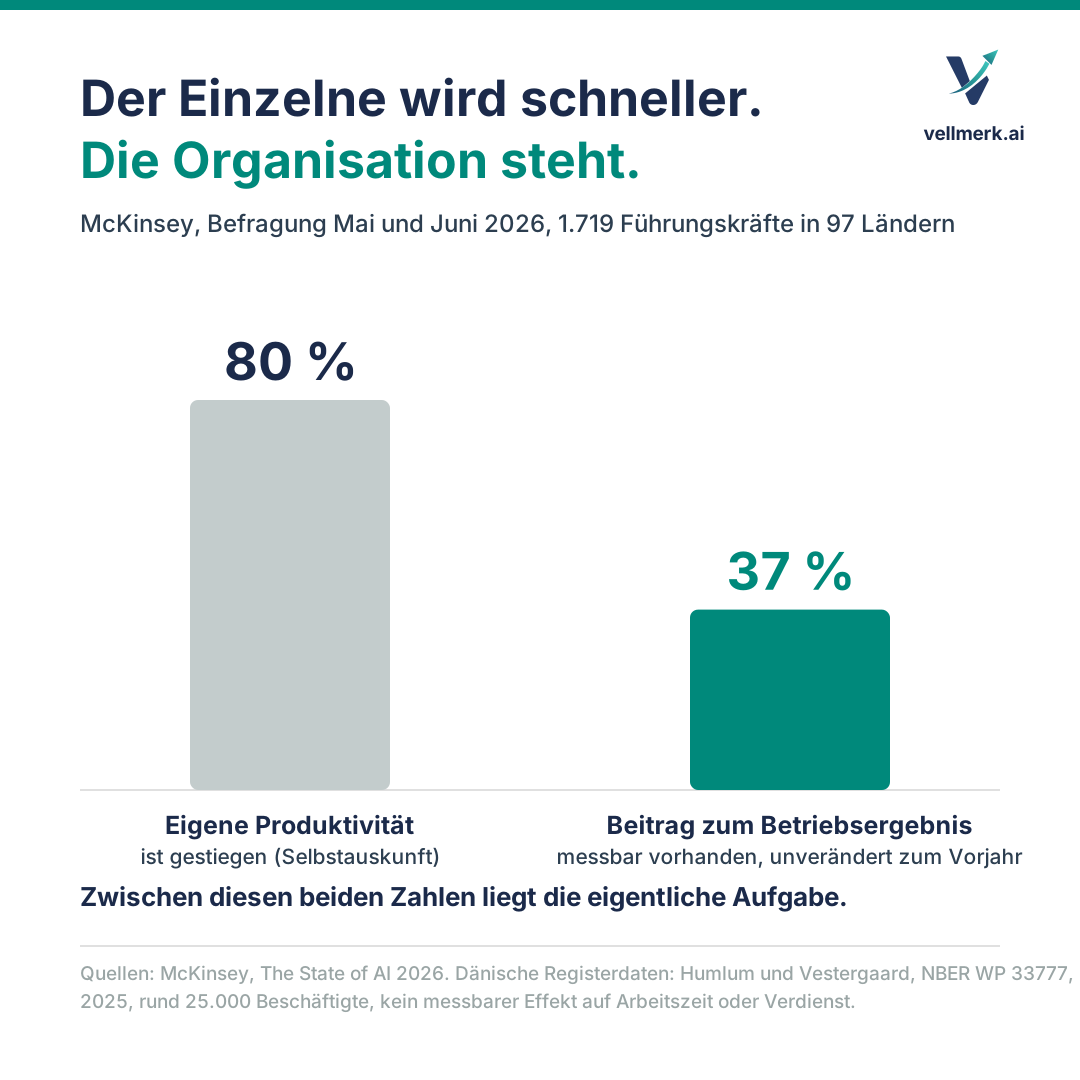
McKinsey kommt in größerem Maßstab zum selben Bild und hat dafür im Mai und Juni 2026 1.719 Führungskräfte in 97 Ländern befragt. 80 Prozent berichten, ihre eigene Produktivität sei gestiegen. 37 Prozent sehen einen Beitrag zum Betriebsergebnis, unverändert gegenüber dem Vorjahr.
Den härtesten Beleg dafür liefert eine dänische Untersuchung, und sie ist deshalb hart, weil sie nicht auf Selbstauskunft beruht. Humlum und Vestergaard haben für ein Arbeitspapier des NBER vom Mai 2025 Registerdaten von rund 25.000 Beschäftigten aus 7.000 Arbeitsstätten in elf Berufen ausgewertet. KI-Chatbots hatten keinen signifikanten Effekt auf Verdienst oder Arbeitszeit. Effekte über zwei Prozent nach zwei Jahren schließen die Autoren aus.
Dieses Ergebnis wird gern als Beleg dafür gelesen, dass KI nicht funktioniert. So steht es dort nicht. Gemessen wurden zwei Größen aus dem Melderegister, Verdienst und erfasste Arbeitszeit, und beide bewegen sich nach zwei Jahren nicht. Die Autoren selbst schreiben, Arbeitgeber fingen die Technik über die Umverteilung von Aufgaben auf, und technischer Wandel verändere die Arbeit lange bevor er in Löhnen oder Stunden sichtbar werde.
Für diesen Artikel ist das die interessantere Aussage. Am Lohnzettel zeigt sich die Wirkung zuletzt. Davor liegt alles, worum es hier geht: wer welche Aufgabe übernimmt, welche Daten dafür taugen, wer das Ergebnis prüft. Belegt ist damit nur, dass nach zwei Jahren nichts davon im Verdienst angekommen war.
 KI-generiert
Es scheitert nicht die KI
Die RAND Corporation hat 2024 fünfundsechzig Data Scientists und Ingenieure mit mindestens fünf Jahren Erfahrung befragt, warum KI-Vorhaben scheitern. Die häufigste Ursache ist keine technische: „stakeholders often misunderstand or miscommunicate the problem that AI needs to solve“. Auf den weiteren Plätzen stehen fehlende Daten, eine Fixierung auf die neueste Technologie statt auf das Problem der Nutzer, und eine Infrastruktur, die den Betrieb nicht trägt.
Das sind dieselben Gründe, aus denen auch ein Lagerverwaltungsprojekt oder eine Dokumentenmanagement-Einführung scheitert. Meine Erfahrung deckt sich damit ziemlich genau.
Ein KI-Projekt scheitert an denselben Dingen wie andere Projekte auch, an unklaren Zielen, an schlechten Daten, an mangelnder Vorbereitung oder fehlenden Informationen und an ungeklärten Zuständigkeiten. Das Besondere bei der KI ist nur, dass man das Scheitern für ein technisches Problem halten kann, obwohl es keines ist.
Die vier Muster, die ich am häufigsten sehe
Das Werkzeug wird vor dem Problem gewählt
Der Chatbot ist die Reflexlösung, weil er sichtbar ist. Nach einer Bitkom-Erhebung setzen 88 Prozent der KI-Nutzer die Technologie im Kundenkontakt ein. Internes Wissensmanagement, wo die Hebel oft größer sind, kommt auf 11 Prozent. Im Schnitt hat ein Unternehmen genau zwei KI-Anwendungen, ein Viertel hat exakt eine.
Dasselbe NANDA-Papier, das die fragwürdigen 95 Prozent enthält, hat an anderer Stelle einen Befund, den ich für den nützlichsten des ganzen Dokuments halte. Zwischen 50 und 70 Prozent der GenAI-Budgets fließen in Marketing und Vertrieb, obwohl Automatisierung im Backoffice meist den besseren Ertrag liefert. Die Begründung der Autoren: Das spiegele nicht den Wert, sondern wie leicht sich Kennzahlen zuordnen lassen.
Die Daten tragen nicht
Gartner hat im Juli 2024 1.203 Verantwortliche für Datenmanagement befragt. 63 Prozent hatten keine oder keine gesicherten Praktiken für KI-taugliche Daten. Die Prognose daraus: 60 Prozent der Vorhaben ohne solche Daten werden bis Ende 2026 aufgegeben. Eine Befragung von rund 600 Datenverantwortlichen im Januar 2026 kommt zum selben Schluss, dort nennen 91 Prozent die Datenzuverlässigkeit als Bremse auf dem Weg vom Piloten in den Betrieb.
Beim Bitkom nennen 50 Prozent der Unternehmen die Datenaufbereitung als großen Kostenpunkt, genauso viele wie die Infrastruktur. Warum das so ist und was vorher zu klären wäre, habe ich in Daten sind nicht das neue Öl und in Die drei Inseln der Wahrheit ausführlicher beschrieben.
Der Pilot kommt nie an
Deloitte hat Ende 2024 2.773 Führungskräfte in 14 Ländern befragt. 68 Prozent hatten höchstens 30 Prozent ihrer GenAI-Experimente in Produktion gebracht, nur 5 Prozent mehr als 70 Prozent. In der Nachfolgeerhebung vom Januar 2026 geben 25 Prozent an, mindestens 40 Prozent geschafft zu haben. Die Zahlen streuen stark, weil Pilot, Experiment und Machbarkeitsnachweis in jeder Studie etwas anderes bedeuten.
Die Richtung ist trotzdem eindeutig, und sie ist alt. McKinsey hat das Phänomen schon 2018 für Industrie 4.0 beschrieben und „pilot purgatory“ genannt. Damals fühlten sich 92 Prozent der Befragten auf Augenhöhe mit dem Wettbewerb, skaliert hatten 30 Prozent.
Die Organisation lernt nicht mit
Dieses Muster halte ich für das folgenreichste. In der Deloitte-Erhebung vom Januar 2026 geben 84 Prozent an, nach der Einführung von KI keine einzige Rolle neu zugeschnitten zu haben. Von denen, die Zugang zu KI-Werkzeugen haben, nutzen weniger als 60 Prozent sie im Alltag. Bei McKinsey haben die wenigen Unternehmen mit nennenswertem Ergebnisbeitrag zu etwa drei Vierteln ihre Abläufe grundlegend umgebaut, bei allen übrigen war es rund ein Viertel.
Das ist der Punkt, an dem aus einem Werkzeugkauf eine Veränderung wird oder eben nicht. Ein Modell, das in einen unveränderten Prozess gesetzt wird, beschleunigt diesen Prozess und sonst nichts.
Warum Aufnahmefähigkeit wichtiger ist als Technik
Für das, was hier fehlt, gibt es einen älteren und ziemlich präzisen Begriff. Wesley Cohen und Daniel Levinthal haben 1990 im Administrative Science Quarterly die absorptive capacity beschrieben, die Fähigkeit einer Organisation, externes Wissen zu bewerten, aufzunehmen und anzuwenden. Ihr Befund: Diese Fähigkeit hängt vom bereits vorhandenen Wissen ab, sie ist kumulativ und pfadabhängig. Man kann sie nicht einkaufen und nicht überspringen.
Daraus folgt unmittelbar, warum ein guter Dienstleister allein nicht genügt. Er bringt externes Wissen. Ob das Haus es aufnehmen kann, entscheidet sich im Haus. Und es erklärt, warum der Sprung von null auf hundert selten gelingt: Die ersten, einfachen Anwendungen sind nicht nur Ertrag, sie sind die Voraussetzung dafür, die nächsten beurteilen zu können.
Peter Senge hat 1990, im selben Jahr, die lernende Organisation beschrieben und das Systemdenken als die integrierende Disziplin bezeichnet. Von seinen fünf Disziplinen trägt für unser Problem vor allem diese eine, und sie trägt sehr gut: lokale Optimierung bei globaler Stagnation ist genau die Figur, die die Zahlen oben beschreiben. Man sollte dazusagen, dass Senges Modell normativ ist und nie empirisch geprüft wurde. Belastbar wird der Gedanke erst über die Nachbarkonzepte.
Wissensmanagement galt lange und zu Unrecht als weiches Thema. Mit Künstlicher Intelligenz wird es erst recht zur Voraussetzung dafür, Mehrwert zu erzeugen und Wettbewerbsvorteile zu sichern.
Was gegen meine These spricht
Drei Befunde aus derselben Recherche gehen gegen das, was ich hier schreibe, und ich halte sie für wichtig genug, sie zu nennen.
Externe Anbieter liefern offenbar besser als Eigenbau. In der NANDA-Erhebung stammten 67 Prozent der erfolgreichen Lösungen von außen und 33 Prozent aus eigener Entwicklung, und Projekte aus Partnerschaften gingen doppelt so häufig in Produktion. Das überrascht mich nicht, und ehrlich gesagt sollte es so sein. Ich verdiene mein Geld genau damit, und es wäre ein schlechtes Zeichen, wenn erfahrene Dienstleister im Schnitt schlechtere Ergebnisse lieferten als ein Haus, das zum ersten Mal ein KI-Projekt aufsetzt. Die Zahl sagt allerdings nicht, dass das Wissen im eigenen Haus damit verzichtbar wird. Ein Unternehmen, das nur einkauft, hat am Ende eine Lösung, die es weder beurteilen noch weiterentwickeln kann.
Auch der Chatbot ist nicht per se falsch. Brynjolfsson, Li und Raymond haben im Quarterly Journal of Economics 2025 die Arbeit von 5.172 Support-Mitarbeitenden ausgewertet und 15 Prozent mehr gelöste Fälle pro Stunde gemessen, bei Berufseinsteigern sogar 34 Prozent. Als Assistent im Arbeitsablauf trägt er also durchaus. Als Ersatz für Menschen, oder als bloßes Schaufenster auf der Startseite, meistens nicht.
Und Beratungshäuser scheitern genauso. Nach einer Erhebung von General Assembly im März 2026 haben 73 Prozent der befragten Beratungsfirmen eigene KI-Projekte abgebrochen, überwiegend wegen fehlender Kompetenzen. Ich würde daraus aber einen anderen Schluss ziehen als den naheliegenden, denn ein abgebrochenes Projekt ist bei einer neuen Technologie nicht per se ein Fehlschlag. Früh zu erkennen, dass sich das Ziel in der erhofften Güte nicht erreichen lässt, und die Mittel daraufhin anders einzusetzen, ist richtiges Arbeiten. Genau so lege ich meine eigenen Projekte an. Wir kommen schnell zu einem Machbarkeitsnachweis, und wenn sich zeigt, dass wir das Erhoffte vermutlich auch mit viel mehr Aufwand nicht erreichen, verteilen wir die Ressourcen neu. Teuer wird das Scheitern erst, wenn es spät kommt.
Woran Sie ein tragfähiges Projekt erkennen
Drei Fragen haben sich für mich als brauchbarster Filter erwiesen. Sie kosten zusammen eine halbe Stunde und ersparen gelegentlich ein halbes Jahr. Ich erkläre sie an einem Beispiel, das in Verwaltungen und Unternehmen gleichermaßen vorkommt: Eingangsrechnungen sollen mit KI vorgeprüft werden.
Erstens, was wird besser und woran würde man das merken?
Die schwache Antwort lautet, die Rechnungsprüfung werde effizienter. Die brauchbare lautet, eine Rechnung liege heute im Schnitt vier Tage bis zur Freigabe und solle künftig an einem Tag durch sein. Erst mit dem heutigen Wert lässt sich später feststellen, ob das Projekt etwas bewirkt hat. Den haben erstaunlich wenige: Bei McKinsey hatte nur etwa ein Fünftel der Unternehmen überhaupt einen festgelegten Weg, die Wirkung von KI zu messen.
Zweitens, wer arbeitet danach anders?
Im Beispiel wäre das etwa die Sachbearbeiterin in der Buchhaltung, die künftig nur noch die Rechnungen prüft, die das System als auffällig markiert, und für die Freigabe der übrigen geradesteht. Lässt sich so eine Person mit einer veränderten Aufgabe nicht benennen, wird kein Prozess verändert, sondern ein Werkzeug gekauft. Das ist der häufigste Fall. In der Deloitte-Befragung vom Januar 2026 hatten 84 Prozent der Unternehmen nach der Einführung von KI keine einzige Rolle neu zugeschnitten. Die Leute bekamen ein neues Werkzeug, ihre Aufgaben und Zuständigkeiten blieben dieselben.
Drittens, welche Daten braucht es, und wem gehören sie?
Um eine Rechnung zu prüfen, braucht das System drei Dinge: die Rechnung selbst, die Bestellung, zu der sie gehört, und die vereinbarten Preise. Die Bestellungen liegen meist sauber im Warenwirtschaftssystem. Die vereinbarten Preise stehen dagegen oft in PDF-Verträgen, in alten E-Mails oder im Kopf einer einzelnen Einkäuferin. Dann endet das Vorhaben, bevor die erste Zeile Code geschrieben ist. Und gibt es niemanden, der diese Daten laufend pflegt, liefert auch ein anfangs gutes System nach einigen Monaten falsche Ergebnisse. Deshalb klärt diese Frage so schnell, ob ein Vorhaben in diesem Jahr realistisch ist. Man muss nur für jedes der drei Dinge fragen, wo es liegt und wer dafür zuständig ist.
Für die Reihenfolge, in der man solche Vorhaben angeht, hilft die Vellmerk-Matrix, die sie nach Wirkung und Aufwand sortiert. Und bevor Sie ein Modell einsetzen, lohnt die Gegenprobe, ob es überhaupt KI braucht oder ob eine einfache Regel das Problem billiger löst.
Wenn Sie eine zweite Meinung brauchen
Vieles davon lässt sich im Haus klären. Manchmal fehlt dafür schlicht die Erfahrung mit KI-Projekten, weil es die ersten sind, und genau dort lohnt eine zweite Meinung von außen.
Wir bauen Lösungen nicht nur selbst, wir arbeiten auch als Sparringspartner. Das eigentliche Bauen kann dann in Ihrem Team bleiben oder bei Ihrem bisherigen Dienstleister, und wir übernehmen die Qualitätssicherung. Wir helfen bei der Planung, bei der Einordnung in Ihre Strategie und bei den Faktoren, die man im Tagesgeschäft leicht übersieht.
Wie das aussieht, lässt sich sehr unterschiedlich zuschneiden. Sie können uns allein für die Strategie dazuholen. Sie können ein Angebot oder ein Konzept eines Dienstleisters von uns bewerten lassen, bevor Sie unterschreiben, oder ein laufendes Projekt auf Zielklarheit, Datenlage und Betriebsfähigkeit prüfen lassen. Sie können Ihren eigenen Entwicklern jemanden an die Seite stellen, mit dem sie Entwurfsentscheidungen durchsprechen, oder uns die Projektsteuerung übergeben.
Unser Qualitätsmanagement ist nach ISO 9001 zertifiziert, und wir betreiben es selbst mit KI-Unterstützung. Das ist kein Gütesiegel für KI-Projekte, aber es heißt, dass wir die Prüfperspektive gewohnt sind. Wenn Sie an einer dieser Stellen jemanden brauchen, sprechen Sie mich an. Im ersten Gespräch lässt sich meistens schon sagen, ob sich der Aufwand lohnt.
Quellen und Weiterführendes
- MIT Project NANDA: The GenAI Divide, State of AI in Business 2025, Juli 2025
- Futuriom: Kritik an der NANDA-Studie, 26. August 2025
- Bitkom: Erstmals nutzt die Mehrheit der Unternehmen KI, 14. September 2026
- Bitkom Studienbericht Künstliche Intelligenz, Februar 2026
- Humlum und Vestergaard: Large Language Models, Small Labor Market Effects, NBER Working Paper 33777
- RAND: The Root Causes of Failure for Artificial Intelligence Projects, August 2024
- Gartner: Lack of AI-Ready Data Puts AI Projects at Risk, 26. Februar 2025
- Brynjolfsson, Li und Raymond: Generative AI at Work, NBER Working Paper 31161
- Cohen und Levinthal: Absorptive Capacity, Administrative Science Quarterly 35(1), 1990
- Rechnungshof Österreich: KI in der Bundesverwaltung, Reihe Bund 2025/20